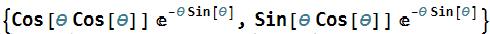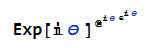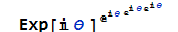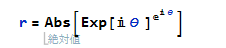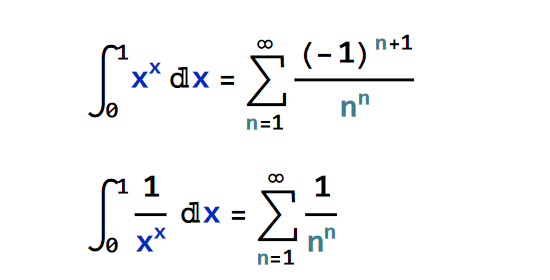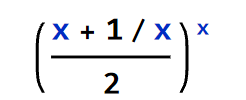義務教育では十年近くかけて、漢字を習う。そこでは漢字は一文字でも深い意味があるのを身に付けさせられる。
「契約」という2文字の熟語はコントラクトという法的行為であるが、約するという文字と契るという文字からなる。約は約束の約であり、契るとは固い束縛があることを意味する。
「原文」は文章の種類を示しているが、「原」が示すのはオリジナルであり、始まりであり、それ以上さかのぼれないことを示唆する。
以上の例からわかるのは、熟語はそれを構成する漢字から、意味が合成される&暗示されていることである。
漢字をこのように結合することで、複雑な意味、事象や行為を即座に理解できるようになるまで日本人は義務教育で叩き込まれる。
以上から、どんな結論を導きたいのか?
LLMではトークンは多次元空間におけるベクトルになる。漢字も同様であろう。原理的にどの程度の「意味空間」つまり、「契約」のような意味的まとまりをもった集合体がその多次元空間にあるのだろうか?
漢字だけでその組合せ数を見積もりたいわけであります。
4文字熟語までの組合せ数は25兆くらいだと見積もれる。広辞苑など辞書に記載されている漢語は多くて40万語だそうだ。
その議論を下にまとめた。
1. 歴史的・後継の区分:常用漢字(じょうようかんじ)
一般に「当用漢字」と対になる存在として最も挙げられるのが常用漢字です。
- 当用漢字(1946年制定・1,850字): 戦後の漢字制限政策として「当分の間、用いる漢字」として定められた、強い制限(これ以外の漢字は原則使わない)を目的とした一覧でした。
- 常用漢字(1981年制定・現行2,136字): 当用漢字の制限性が厳しすぎたことへの反省から、当用漢字表を廃止して新たに制定された現行の基準です。制限ではなく「現代の国語を書き表すための目安・よりどころ」という緩やかな位置づけになっています。
2. 用途別の区分(名付けの漢字):人名用漢字(じんめいようかんじ)
戸籍法における「名前に使える漢字」という分類の観点では、人名用漢字が対になります。
- 1948年に「子の名に使える漢字は当用漢字に限る」と定められた結果、従来の名前によく使われていた字が使えなくなり混乱が生じました。
- その救済措置として1951年に新設されたのが人名用漢字(当用漢字/常用漢字の枠外で、人名にのみ使用が認められている漢字群)です。
|
区分 |
制定年 |
目的・性格 |
現行の扱い |
|
当用漢字 |
1946年 |
漢字使用の制限(1,850字) |
廃止(1981年に常用漢字へ移行) |
|
常用漢字 |
1981年 |
一般社会生活での目安(2,136字) |
現行(一般文書・法令・公用文の基準) |
|
人名用漢字 |
1951年 |
子の名付け用(常用漢字外の追加字) |
現行(863字) |
User prompt: 常用漢字と当用漢字で合わせて4000字ですが、4文字漢字までの組合せは何種類になりますか?重複は許さないとして計算しなさい。
Response: 提示された条件(漢字 n=4,000 字、重複なし、1文字から4文字まで)における総数は、文字の並び順を区別するかどうかによって以下の通り計算されます。
- 熟語など「並び順を区別する」場合(順列): 255兆6801億4398万4000通り
- 文字の「選ばれた集合のみを考え、並び順を区別しない」場合(数学的な組合せ): 10兆6613億4066万9000通り
1. 並び順を区別する場合(順列 nPr)
漢字の並び(熟語や文字列)として区別する場合の計算です。
- 1文字: 4000P1=4,000 通り
- 2文字: 4000P2=4,000×3,999=15,996,000 通り
- 3文字: 4000P3=4,000×3,999×3,998=63,952,008,000 通り
- 4文字: 4000P4=4,000×3,999×3,998×3,997=255,616,175,976,000 通り
4,000+15,996,000+63,952,008,000+255,616,175,976,000=255,680,143,984,000
2. 並び順を区別しない場合(組合せ nCr)
選ばれた漢字の組み合わせそのものに着目し、並び替えを同一視する場合の計算です。
- 1文字: 4000C1=4,000 通り
- 2文字: 4000C2=2!4,000×3,999=7,998,000 通り
- 3文字: 4000C3=3!4,000×3,999×3,998=10,658,668,000 通り
- 4文字: 4000C4=4!4,000×3,999×3,998×3,997=10,650,673,999,000 通り
4,000+7,998,000+10,658,668,000+10,650,673,999,000=10,661,340,669,000
実態としての漢字数に関する補足
常用漢字(2,136字)は旧来の当用漢字(1,850字)のほとんどを引き継いで改定されたため、両者の文字群は大部分が重複しています(実際の重複を除いたユニーク文字数は約2,150字程度)。今回の計算はご提示の「合わせて4,000字」という前提条件に基づいています。
User prompt: なるほど、ユニーク漢字は2150文字であるのならば、4文字までの順番を考慮した組合せの熟語の数を出してください
Response: ユニークな漢字 n=2,150 字を用い、順番を考慮して作ることができる4文字までの熟語(文字列)の総数は、直前の条件を引き継ぎ重複を許さない場合、21兆3178億5596万8900通りです。
1. 重複を許さない場合(順列 nPr)
同じ漢字を2度使わず、並び順を区別する場合の各文字数ごとの内訳です。
- 1文字: 2150P1=2,150 通り
- 2文字: 2150P2=2,150×2,149=4,620,350 通り
- 3文字: 2150P3=2,150×2,149×2,148=9,924,511,800 通り
- 4文字: 2150P4=2,150×2,149×2,148×2,147=21,307,926,834,600 通り
2,150+4,620,350+9,924,511,800+21,307,926,834,600=21,317,855,968,900
2. 参考:重複を許す場合(重複順列 nr)
「日々」「切磋琢磨」のように同じ漢字の反復を許容する場合の計算です。
- 1文字: 2,1501=2,150 通り
- 2文字: 2,1502=4,622,500 通り
- 3文字: 2,1503=9,938,375,000 通り
- 4文字: 2,1504=21,367,506,250,000 通り
2,150+4,622,500+9,938,375,000+21,367,506,250,000=21,377,449,249,650
(21兆3774億4924万9650通り)
母数が4,000字から2,150字(約54%)に減少したことで、4文字の組み合わせ数はおよそ12分の1(約255.6兆通り → 約21.3兆通り)に絞られます。
User prompt: 実際には広辞苑等の辞書では4文字熟語までの漢字の組合せはどの程度あると推測されますか?
Response: 『広辞苑』をはじめとする中型国語辞典に収録されている「4文字までの漢字のみで構成される見出し語(1字〜4字熟語)」の総数は、およそ10万〜13万語程度と推測されます。
理論上の順列(約21.3兆通り)と比較すると、実際に言葉として成立して辞書に採録されているのは1億分の1以下(約0.0000005%)という極めて限られた領域です。
内訳の推定(『広辞苑』総収録語数 約25万項目を基準)
『広辞苑』の約25万語には、和語(大和言葉)、外来語(カタカナ語)、動詞・形容詞などの活用語、句・ことわざ、人名・地名等の固有名詞が含まれます。これらを除き、純粋な「漢字のみの熟語(漢語等)」を抽出した場合の文字数別の推定規模は以下の通りです。
- 1文字(単漢字語):約3,000 〜 4,000語
- 「愛」「道」「気」「心」など、単独で名詞等の語彙として立項されているもの。
- 2字熟語:約7万 〜 8万語
- 日本語の漢語語彙における圧倒的中核です。「主述」「修飾」「並列」「動賓」など構造が安定しており、近現代の訳語(概念語)も大半が2字で造語されたため、全熟語の約7割を占めます。
- 3字熟語:約1.5万 〜 2万語
- 「2字+接頭辞/接尾辞(新時代、専門家)」や「不+2字(不条理)」、あるいは「三者三様的な定型句」など。自立した語彙としての採録数は2字に比べ大きく減ります。
- 4字熟語:約1万 〜 1.5万語
- いわゆる典故を持つ成句(四字熟語辞典クラスで約4,000〜6,000語)に加え、2字熟語の複合(「環境破壊」「高速道路」「共同声明」など)で1項目として立項されているものを合わせた規模です。
理論値と辞書採録数のギャップが生じる理由
数学的な順列では21兆通りを超えますが、言語として定着するには以下のような強い構造的制約が働くためです。
|
制約要因 |
具体的な内容 |
|
統語構造の制約 |
漢字の結合はランダムではなく、「修飾・被修飾」「主述」「動詞・目的語」など漢文法的なルールに従う組み合わせしか意味を成さない。 |
|
音韻・リズムの制約 |
日本語では2拍・4拍(2字・4字)のリズムが定着しやすく、特に2文字への凝縮圧力が強い。 |
|
歴史的淘汰 |
明治期の翻訳語などで大量に作られた造語の多くが淘汰され、社会的に流通・共有されたものだけが辞書に残る。 |
日本最大級の辞書である『日本国語大辞典』(約50万項目)や、漢和辞典の最高峰『大漢和辞典』(熟語数約53万)まで母集団を広げても、4文字までの漢語総数は30万〜40万語程度にとどまります。
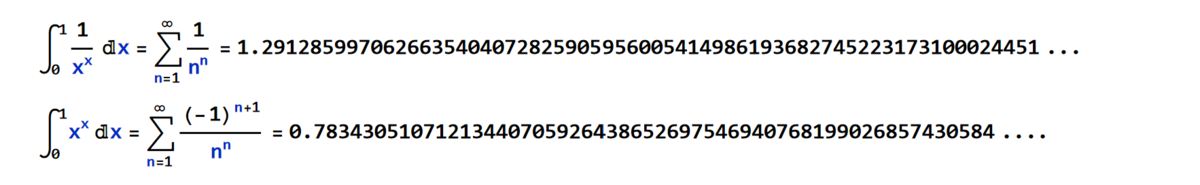
 ={2;4,2,6,2,8,......}
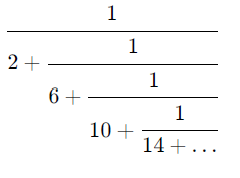
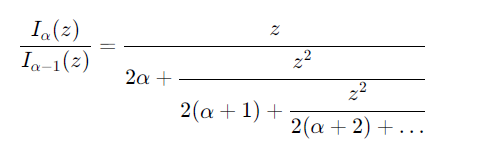
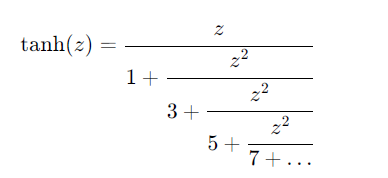
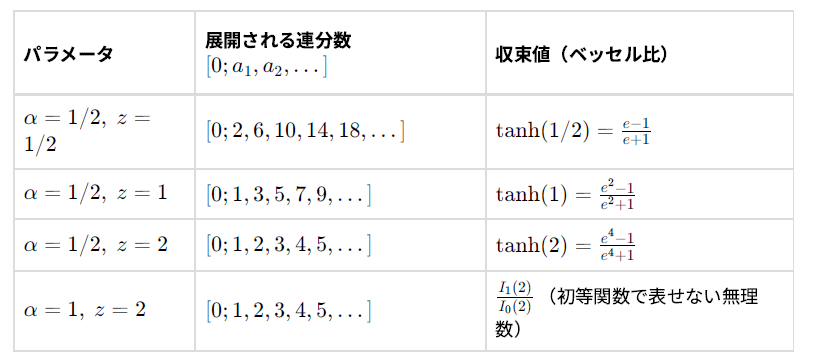


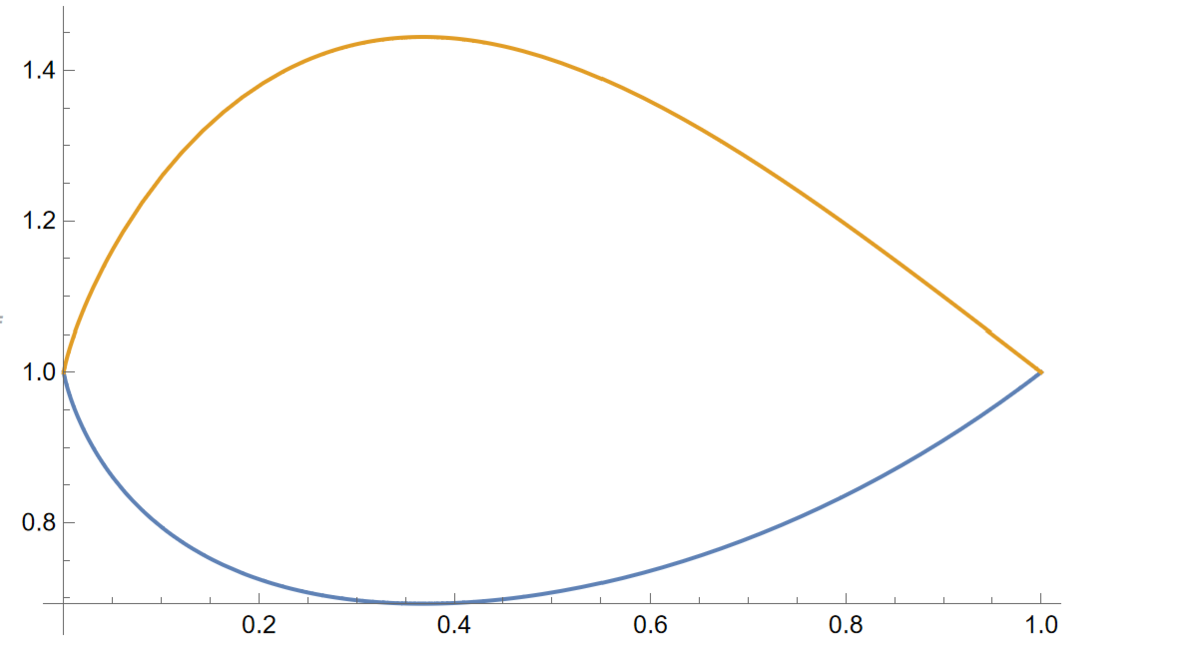
 の数値積分とグラフを計算していて、xに
 を突っ込んだ場合にどのような具合になるかが気になった。